Teil I · Verstehen
Kapitel 2: Von der Lochkarte zum Chatbot
Heutige Sprachmodelle sind das Ergebnis zweier Entwicklungen, die lange nebeneinander herliefen: der Datenverarbeitung, die Rechenleistung, Speicher und Vernetzung lieferte, und der KI-Forschung, die immer neue Ideen hatte, wie Maschinen lernen und denken könnten. Dieses Kapitel erzählt beide Geschichten – und zeigt, wo sie zusammenlaufen.
Zwei Geschichten, die zusammenlaufen
Die Idee, dass Maschinen denken könnten, ist älter als der erste Computer, der diesen Namen verdient. Schon 1950 stellte Alan Turing die Frage, ob Maschinen denken können (Turing 1950), und das Perzeptron, ein frühes lernendes Netz, gab es bereits 1958. Dass es dann noch über sechzig Jahre bis zu ChatGPT dauerte, lag weniger an fehlenden Ideen als an fehlenden Voraussetzungen.
Der folgende Zeitstrahl stellt beide Geschichten nebeneinander. Die obere Spur zeigt die Datenverarbeitung, die untere die künstliche Intelligenz. Die Abschnitte danach erzählen die wichtigsten Stationen ausführlicher.
Zwei Spuren durch die Geschichte
Wählen Sie ein Ereignis per Klick, Fingertipp oder mit den Pfeiltasten. Darunter erscheinen Erklärung und, wo vorhanden, ein historisches Foto. Bei KI-Ereignissen zeigen grüne Linien, welche Entwicklungen der Datenverarbeitung sie möglich gemacht haben. Die Abstände sind nicht maßstabsgetreu: Jedes Ereignis hat seinen eigenen Platz.
- Datenverarbeitung
- Künstliche Intelligenz
- Ära der Sprachmodelle
- KI-Winter
- machte möglich
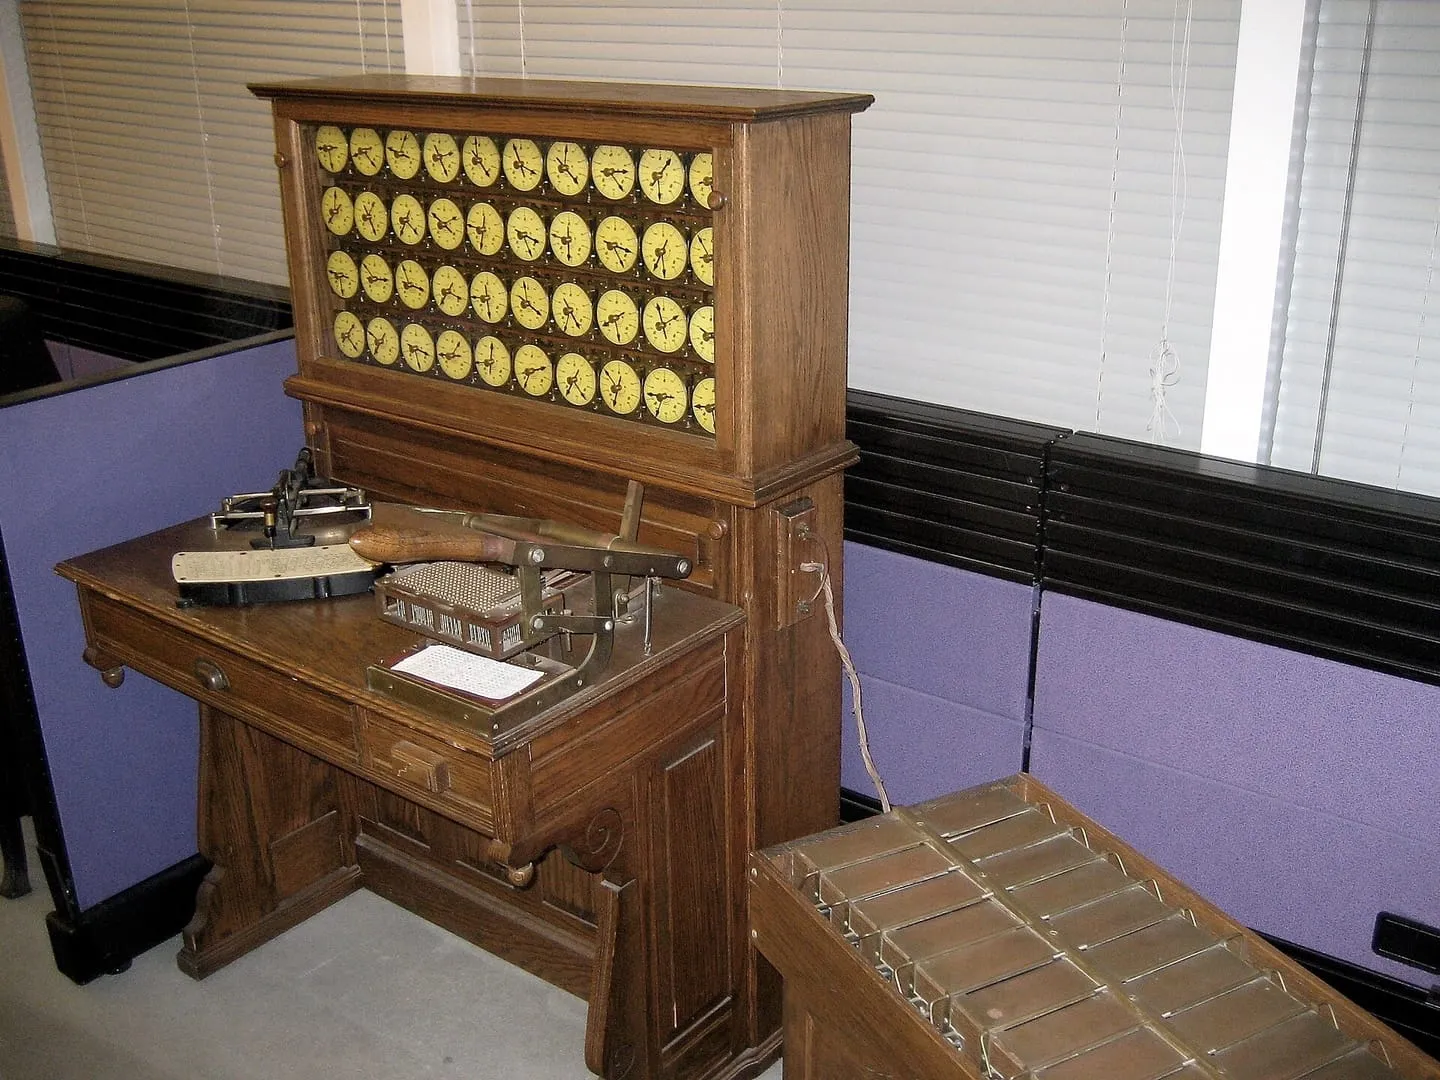
1890 · Datenverarbeitung
Lochkarten zählen das Volk
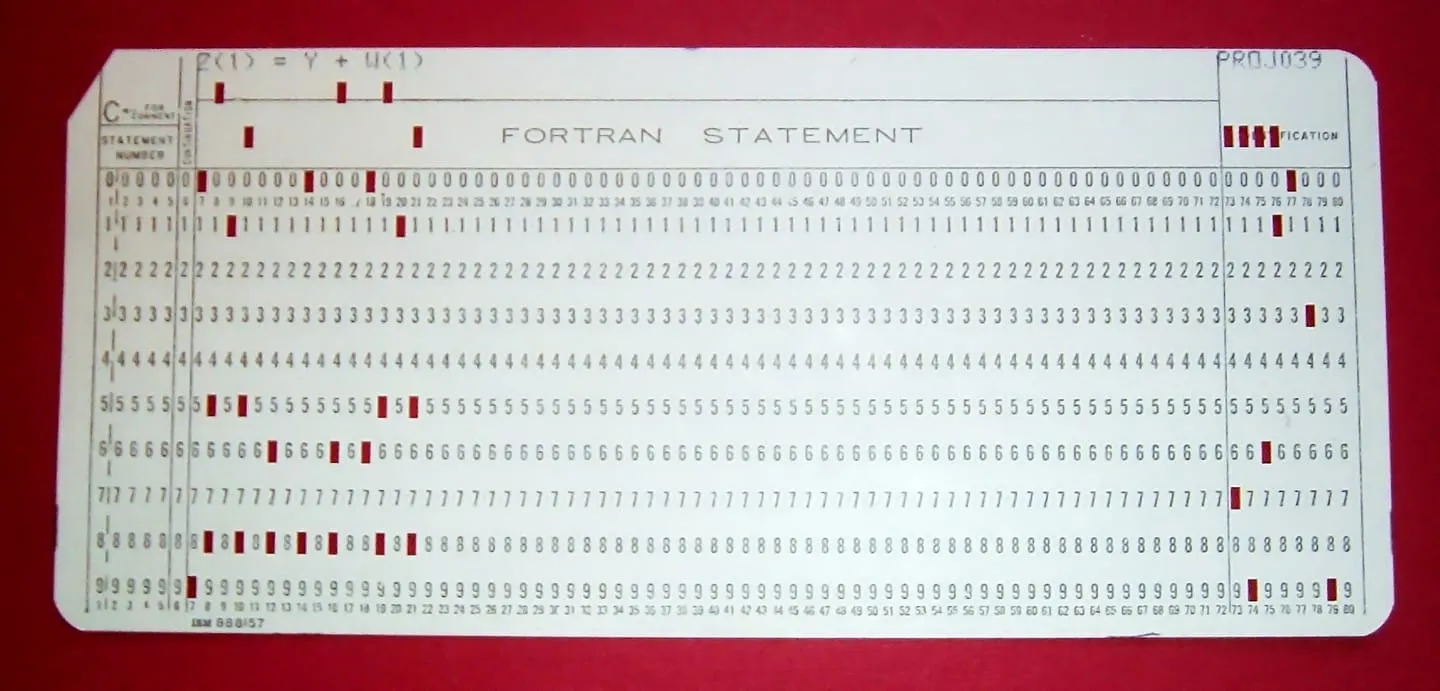
Für die US-Volkszählung werden die Angaben von fast 63 Millionen Menschen in Karten gestanzt und von elektrischen Zählmaschinen Herman Holleriths ausgewertet. Daten werden zum ersten Mal maschinenlesbar. Aus Holleriths Firma geht später IBM hervor.
Darauf baute die KI auf:
- Die Lernbeispiele bekam es als Lochkarten.
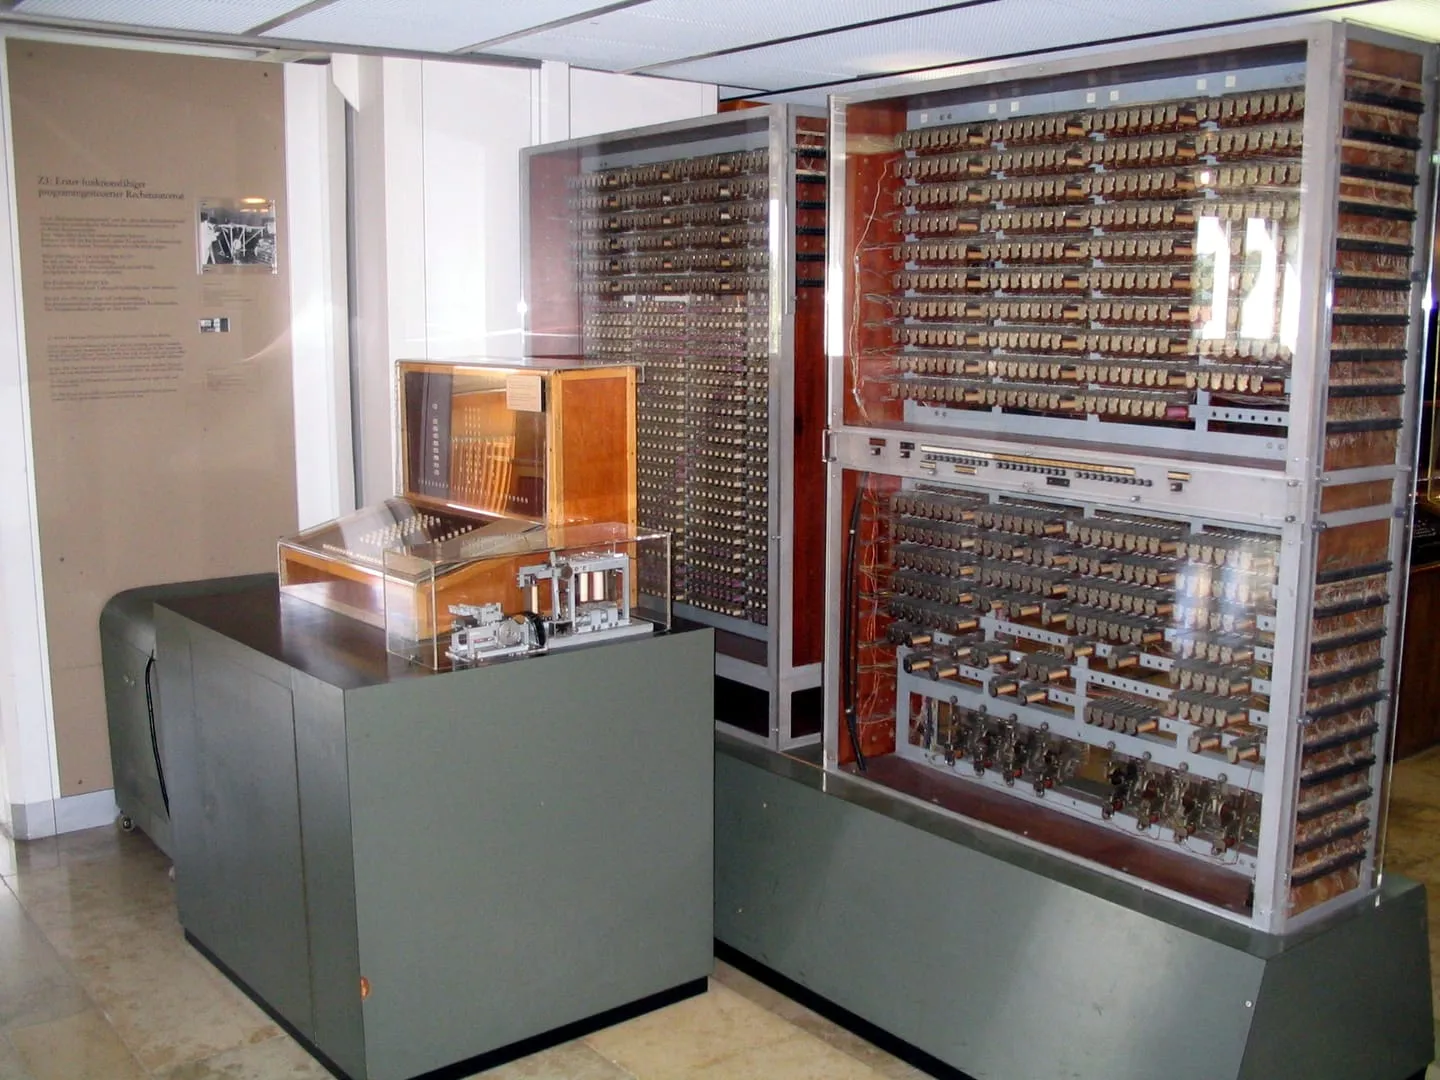
1941 · Datenverarbeitung
Zuses Z3
Konrad Zuse führt in Berlin die Z3 vor, den ersten funktionsfähigen, frei programmierbaren Rechenautomaten. Sie rechnet mit elektromagnetischen Relais im Binärsystem und liest ihr Programm von gelochtem Filmstreifen. Das Original wird im Krieg bei einem Luftangriff zerstört.
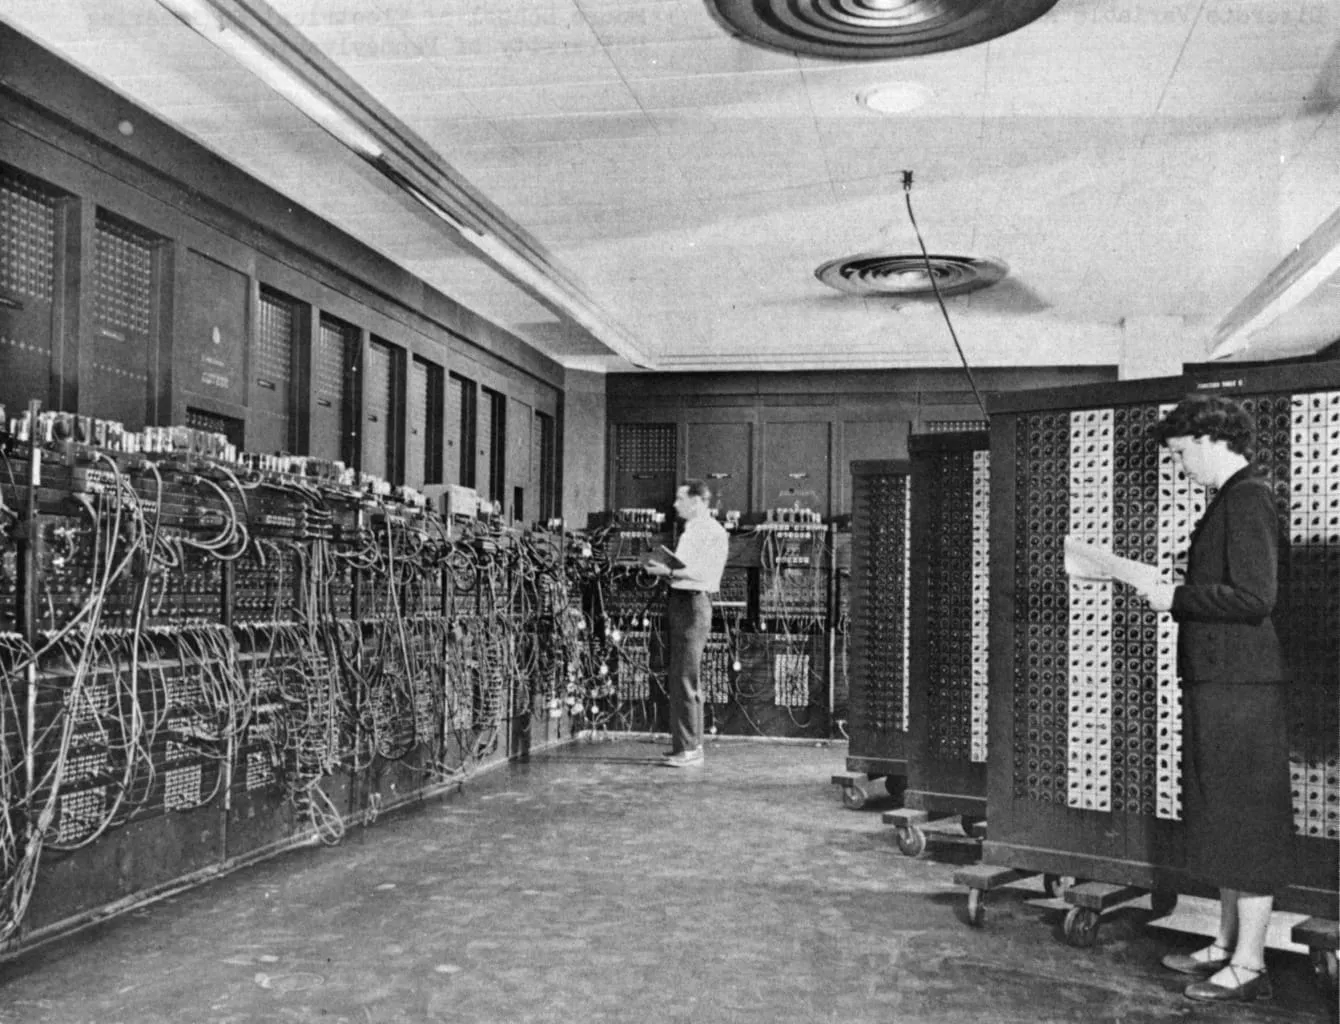
1946 · Datenverarbeitung
ENIAC: Rechnen mit Elektronik
Der ENIAC in Philadelphia rechnet mit Tausenden Elektronenröhren statt mit mechanischen Teilen und ist damit um ein Vielfaches schneller als alle Vorgänger. Er füllt einen ganzen Saal; programmiert wird er anfangs durch Umstecken von Kabeln.
Darauf baute die KI auf:
- Turing schrieb, als die ersten elektronischen Rechner gerade entstanden – und programmierte selbst einen davon in Manchester.
- Das Perzeptron lief zuerst als Simulation auf einem IBM-704-Großrechner, einem Nachfahren der ersten elektronischen Rechner.
1947 · Datenverarbeitung
Der Transistor
In den Bell Laboratories entsteht der Transistor: ein elektronischer Schalter ohne Glühfaden, kleiner, sparsamer und zuverlässiger als die Röhre. Er ist der Grundbaustein jedes heutigen Chips.
1950 · Künstliche Intelligenz
Turing fragt: Können Maschinen denken?
Alan Turing schlägt ein Imitationsspiel vor: Kann ein Mensch im schriftlichen Gespräch unterscheiden, ob er mit einem Menschen oder einer Maschine spricht? Die Frage begleitet das Feld bis heute.
Möglich wurde das durch:
- Turing schrieb, als die ersten elektronischen Rechner gerade entstanden – und programmierte selbst einen davon in Manchester.
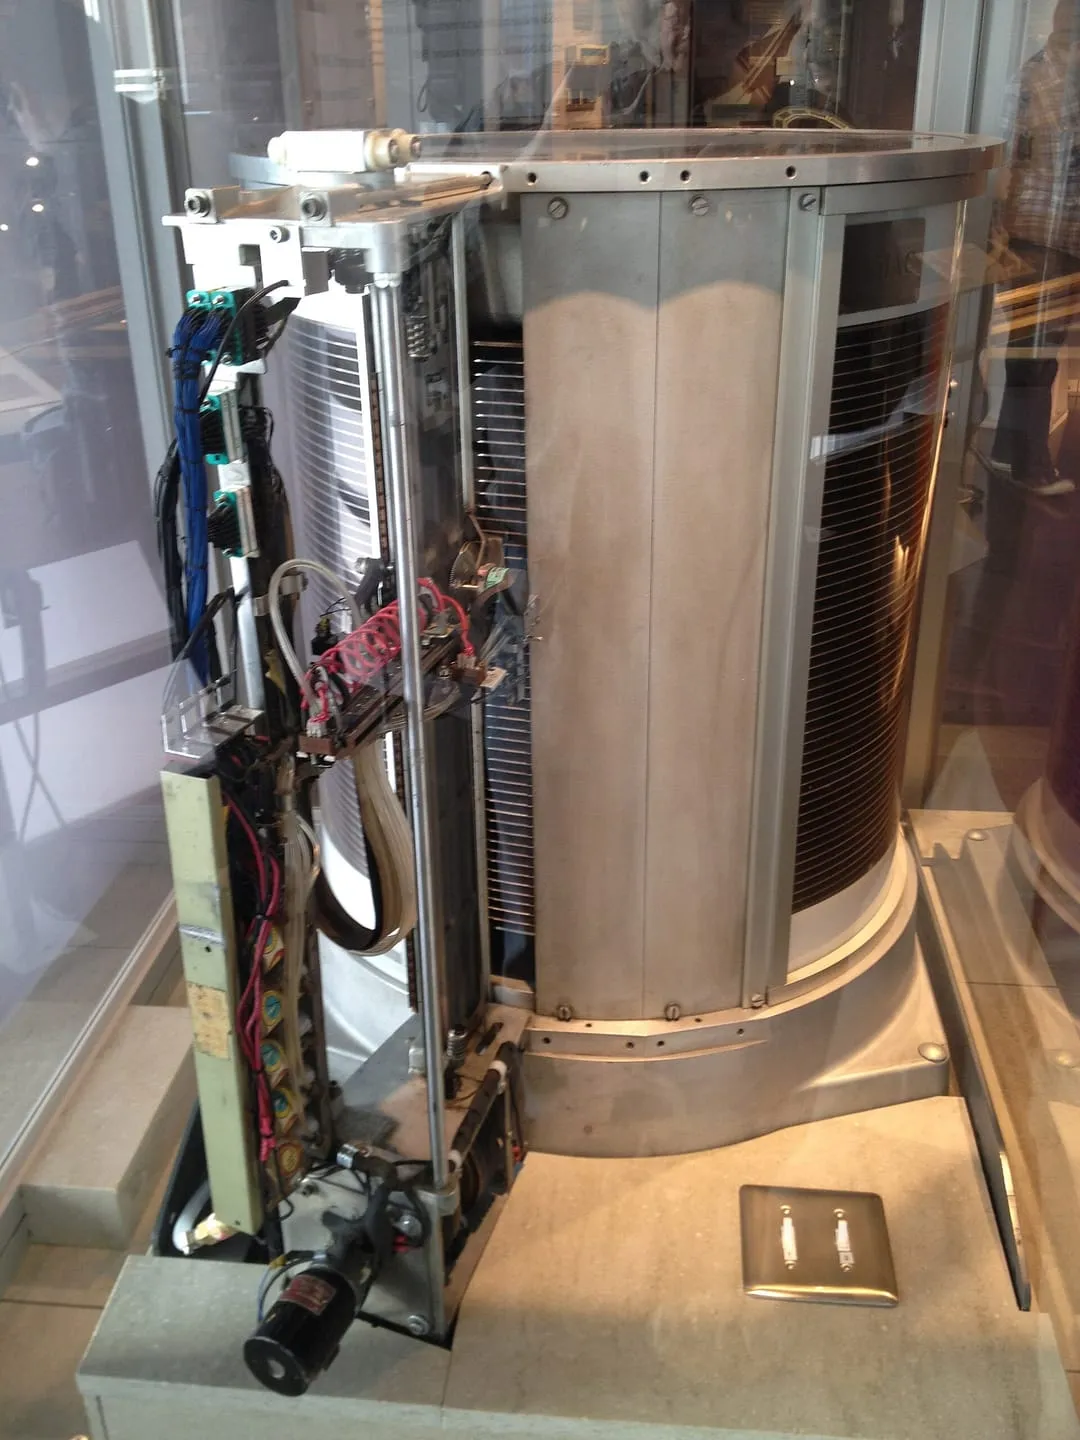
1956 · Datenverarbeitung
Die erste Festplatte
IBM liefert mit dem RAMAC-System die erste Festplatte aus. Sie speichert 5 Millionen Zeichen. Neu ist vor allem der direkte Zugriff: Jeder Datensatz lässt sich unmittelbar anspringen, statt ein Band von vorn abzuspulen.
1956 · Künstliche Intelligenz
Die Dartmouth-Konferenz
Ein Sommer-Workshop am Dartmouth College gibt dem Feld seinen Namen: Artificial Intelligence. Die Antragsteller waren überzeugt, in einem einzigen Sommer bedeutende Fortschritte erzielen zu können.
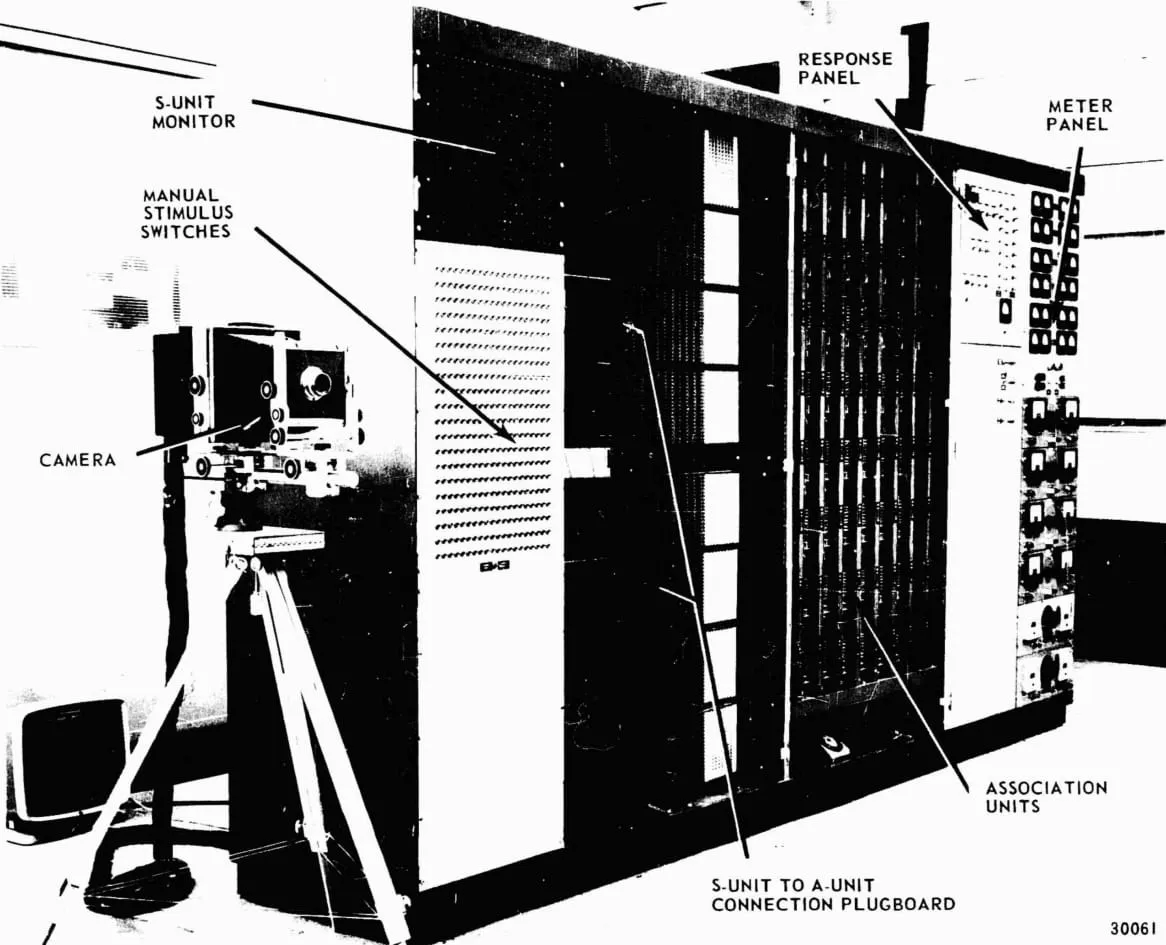
1958 · Künstliche Intelligenz
Das Perzeptron
Frank Rosenblatt stellt ein lernendes künstliches Neuron vor. In der ersten Vorführung lernt es nach 50 Versuchen, Karten mit einer Markierung links von solchen mit einer Markierung rechts zu unterscheiden.
Möglich wurde das durch:
- Das Perzeptron lief zuerst als Simulation auf einem IBM-704-Großrechner, einem Nachfahren der ersten elektronischen Rechner.
- Die Lernbeispiele bekam es als Lochkarten.
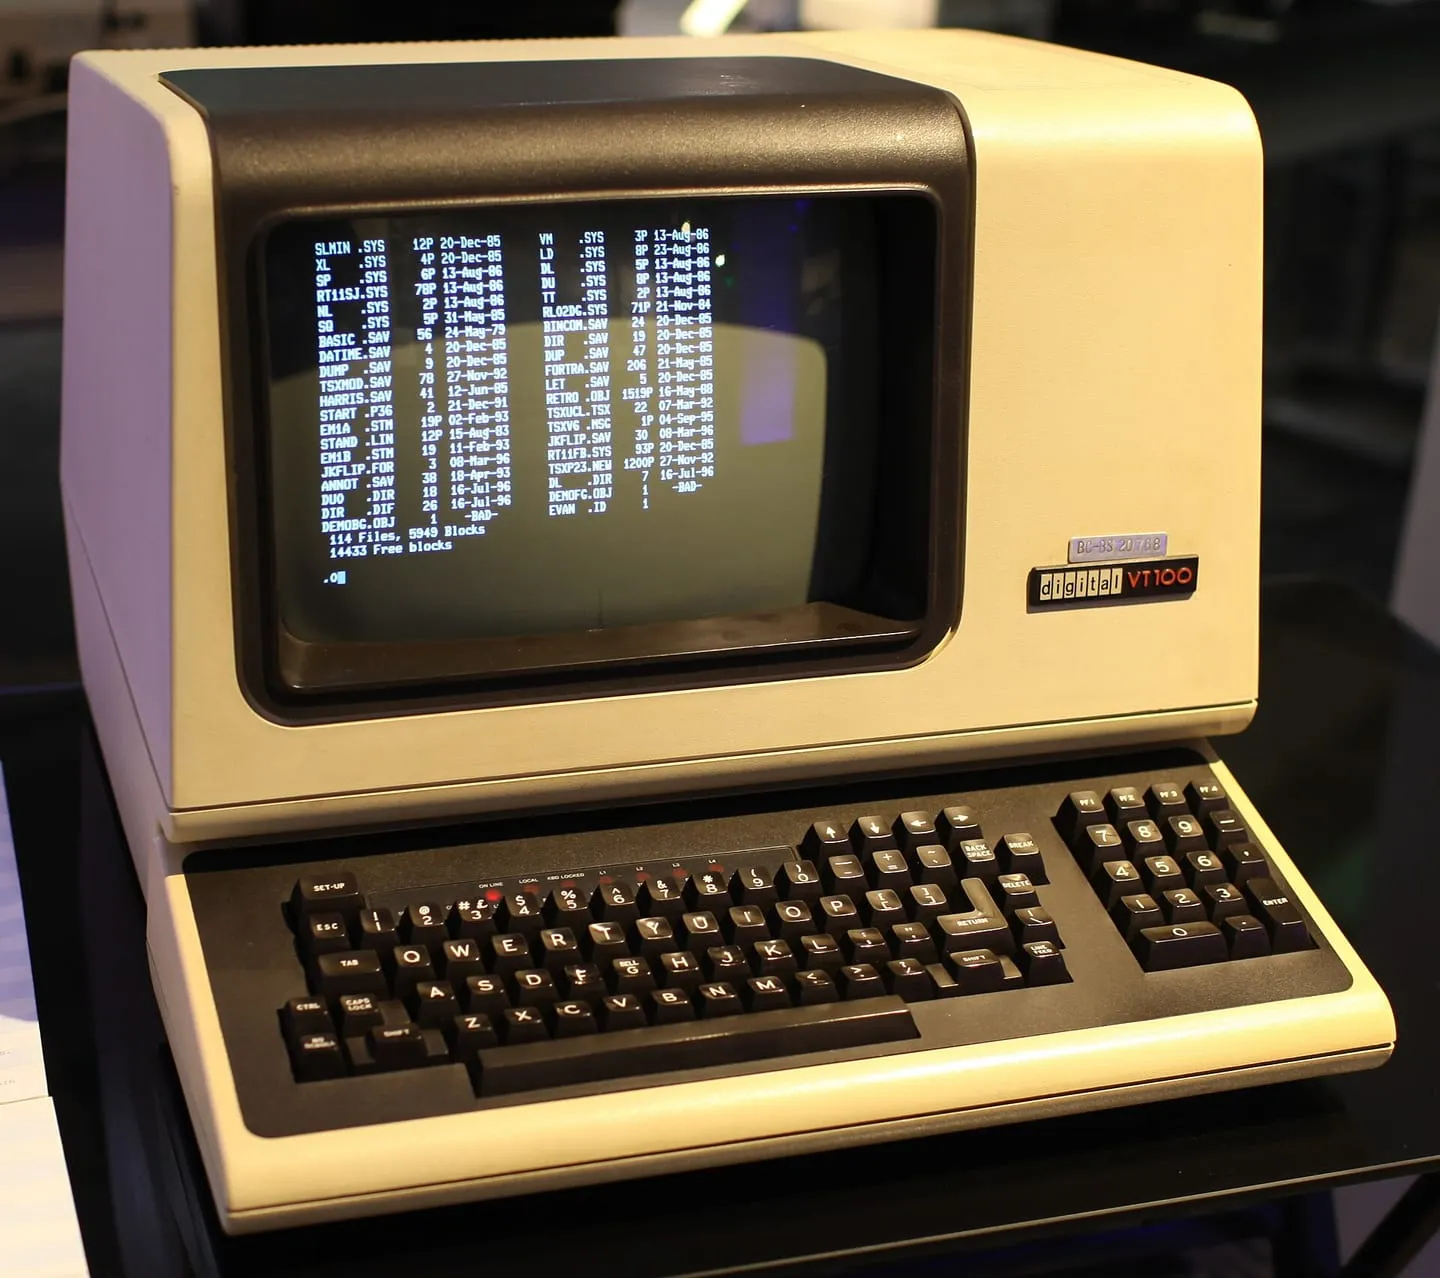
1961 · Datenverarbeitung
Time-Sharing: Der Dialog beginnt
Am MIT wird das Time-Sharing-System CTSS vorgeführt. Mehrere Menschen arbeiten gleichzeitig über Terminals an einem Großrechner, der jedem reihum einen Augenblick Rechenzeit zuteilt. Die Antwort kommt sofort statt am nächsten Tag.
Darauf baute die KI auf:
- ELIZA lief auf dem Time-Sharing-System CTSS: Man tippte am Terminal und bekam sofort eine Antwort – erst das machte ein Gespräch möglich.
- Das Prinzip ist das des Time-Sharings: Sehr viele Menschen teilen sich zentrale Rechner und bekommen trotzdem sofort Antwort.
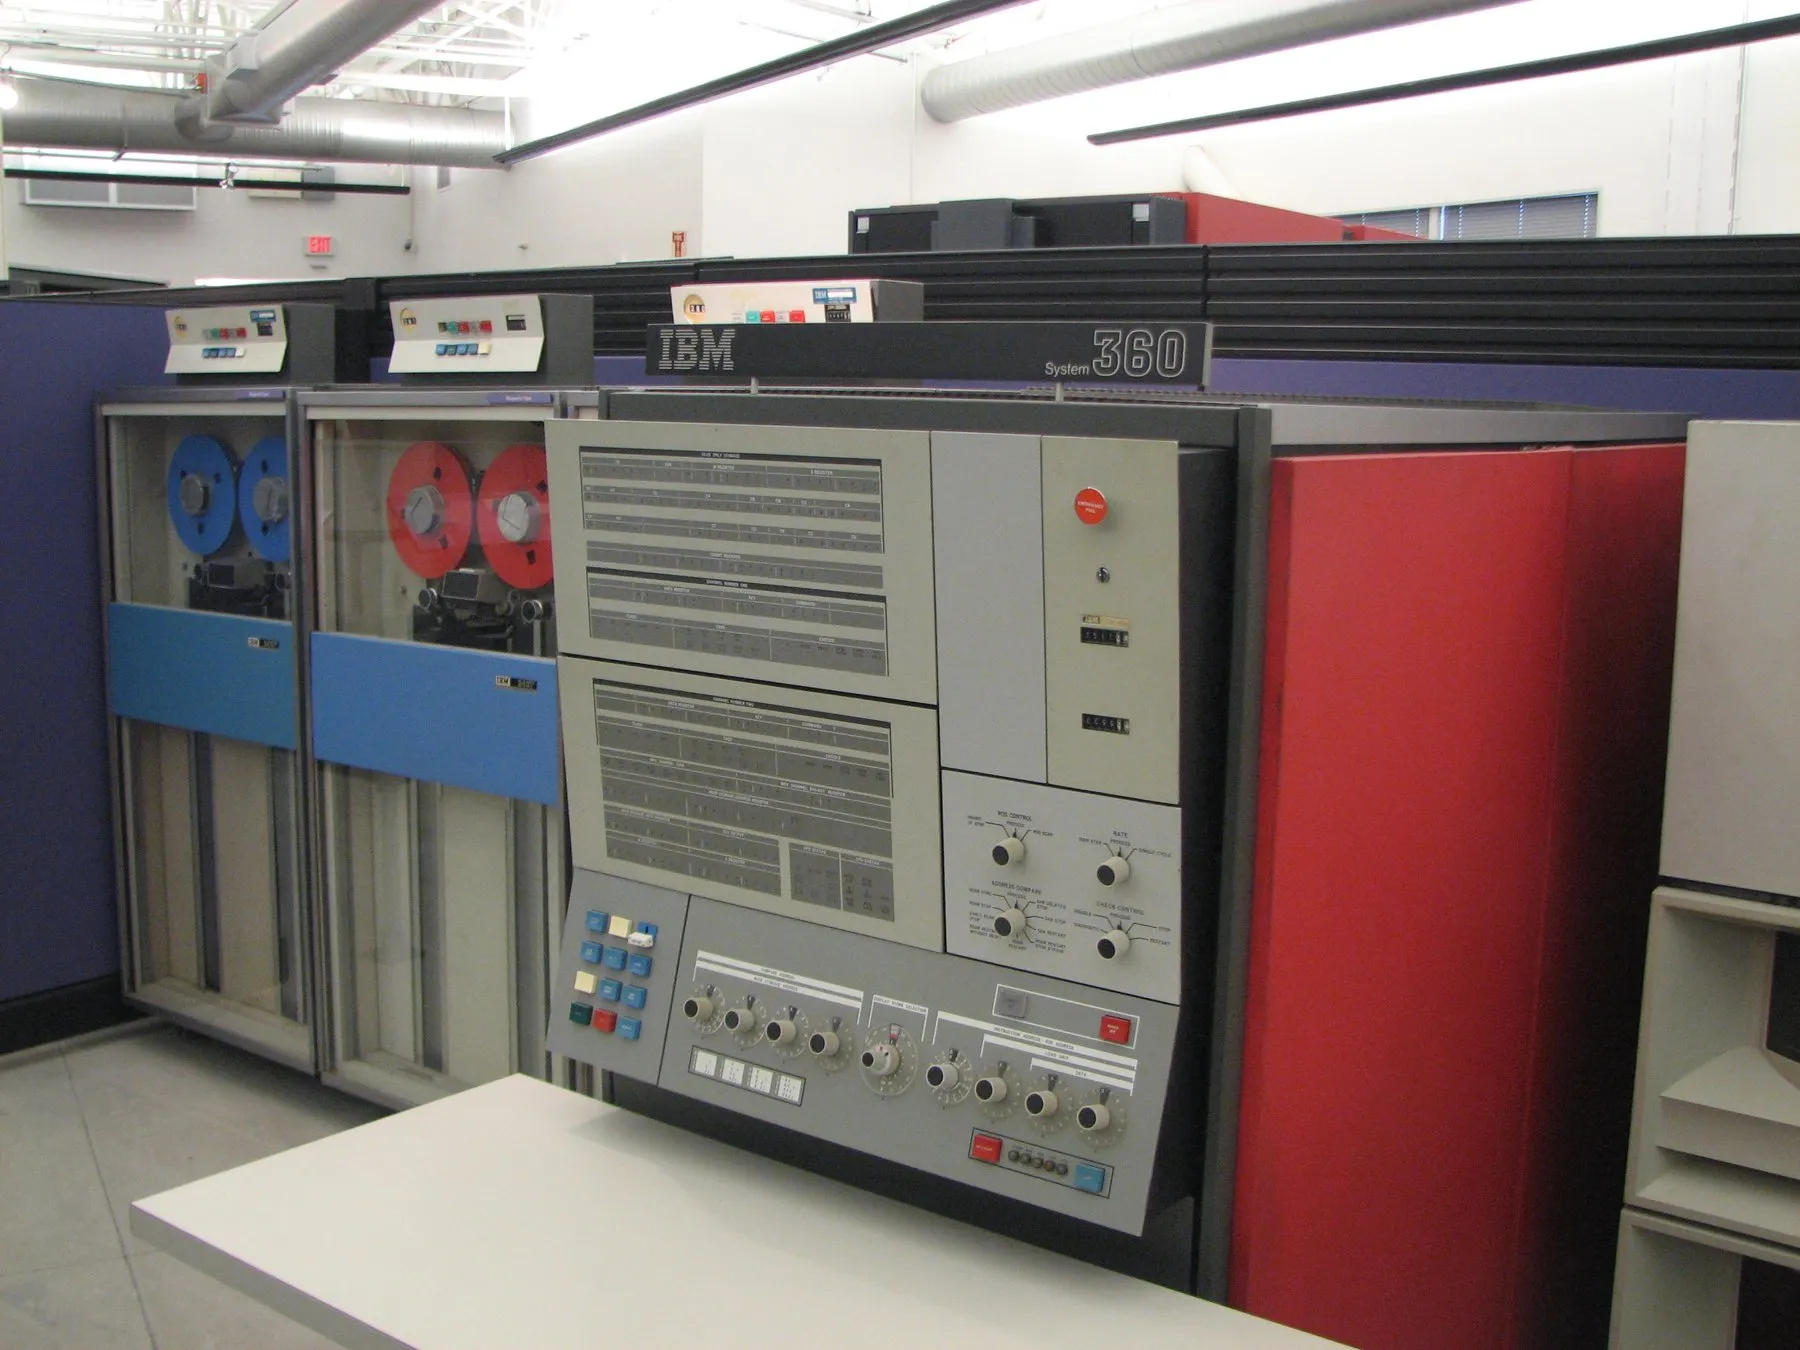
1964 · Datenverarbeitung
IBM System/360
IBM stellt eine ganze Familie von Großrechnern vor, kleine wie große, auf denen dieselben Programme laufen. Das System/360 prägt die Datenverarbeitung von Banken, Versicherungen und Behörden über Jahrzehnte.
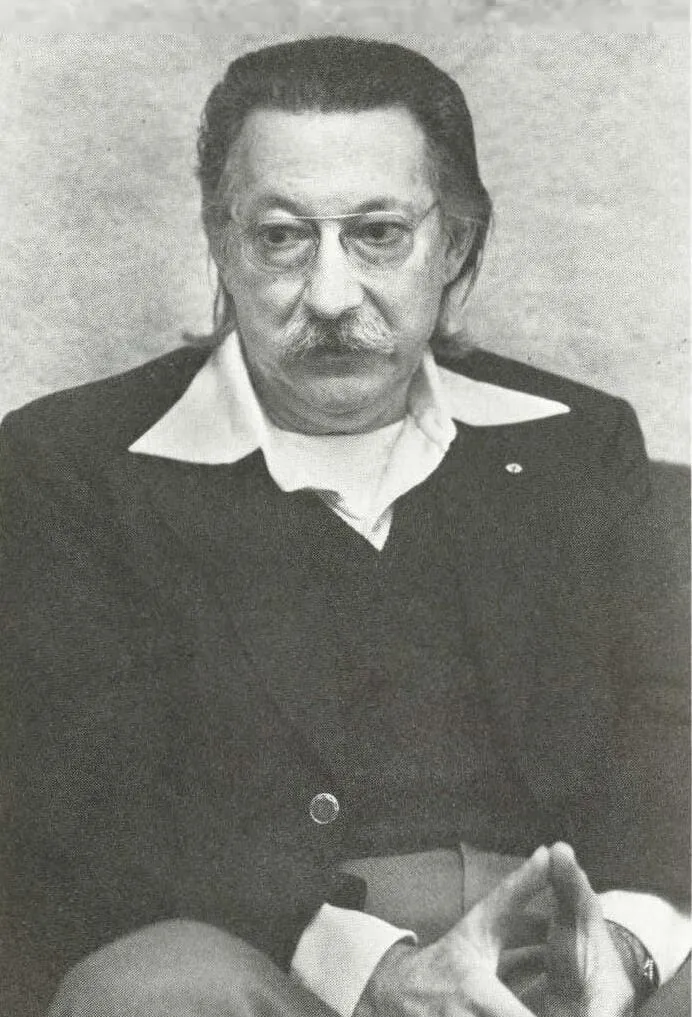
1966 · Künstliche Intelligenz
ELIZA, das erste Chatprogramm
Joseph Weizenbaum schreibt am MIT ein Programm, das Aussagen nach einfachen Mustern als Fragen zurückgibt. Obwohl es nichts versteht, schreiben ihm viele Menschen Verständnis zu. Weizenbaum wird darüber zu einem der ersten Kritiker der KI.
Möglich wurde das durch:
- ELIZA lief auf dem Time-Sharing-System CTSS: Man tippte am Terminal und bekam sofort eine Antwort – erst das machte ein Gespräch möglich.
1969 · Datenverarbeitung
ARPANET, der Vorläufer des Internets
Rechner an Universitäten in Kalifornien und Utah werden zum ARPANET verbunden. Nachrichten werden in kleine Datenpakete zerlegt, die einzeln durch das Netz reisen und am Ziel wieder zusammengesetzt werden – das Grundprinzip des Internets.
1971 · Datenverarbeitung
Der Mikroprozessor
Intel bringt mit dem 4004 einen vollständigen Prozessor auf einem einzigen Chip heraus. Er enthält 2.300 Transistoren. Ab jetzt wird Rechenleistung Jahr für Jahr kleiner, billiger und schneller.
Darauf baute die KI auf:
- Deep Blue rechnete mit 480 eigens entwickelten Schach-Chips – Nachfahren des Mikroprozessors.
1980 · Künstliche Intelligenz
Expertensysteme
Das Wissen von Fachleuten wird in Tausende Wenn-dann-Regeln gefasst. Beim Computerhersteller DEC stellt ab 1980 das System XCON Rechnerbestellungen zusammen. Solche Systeme sind aufwendig zu pflegen und scheitern an allem, was die Regeln nicht vorsehen.
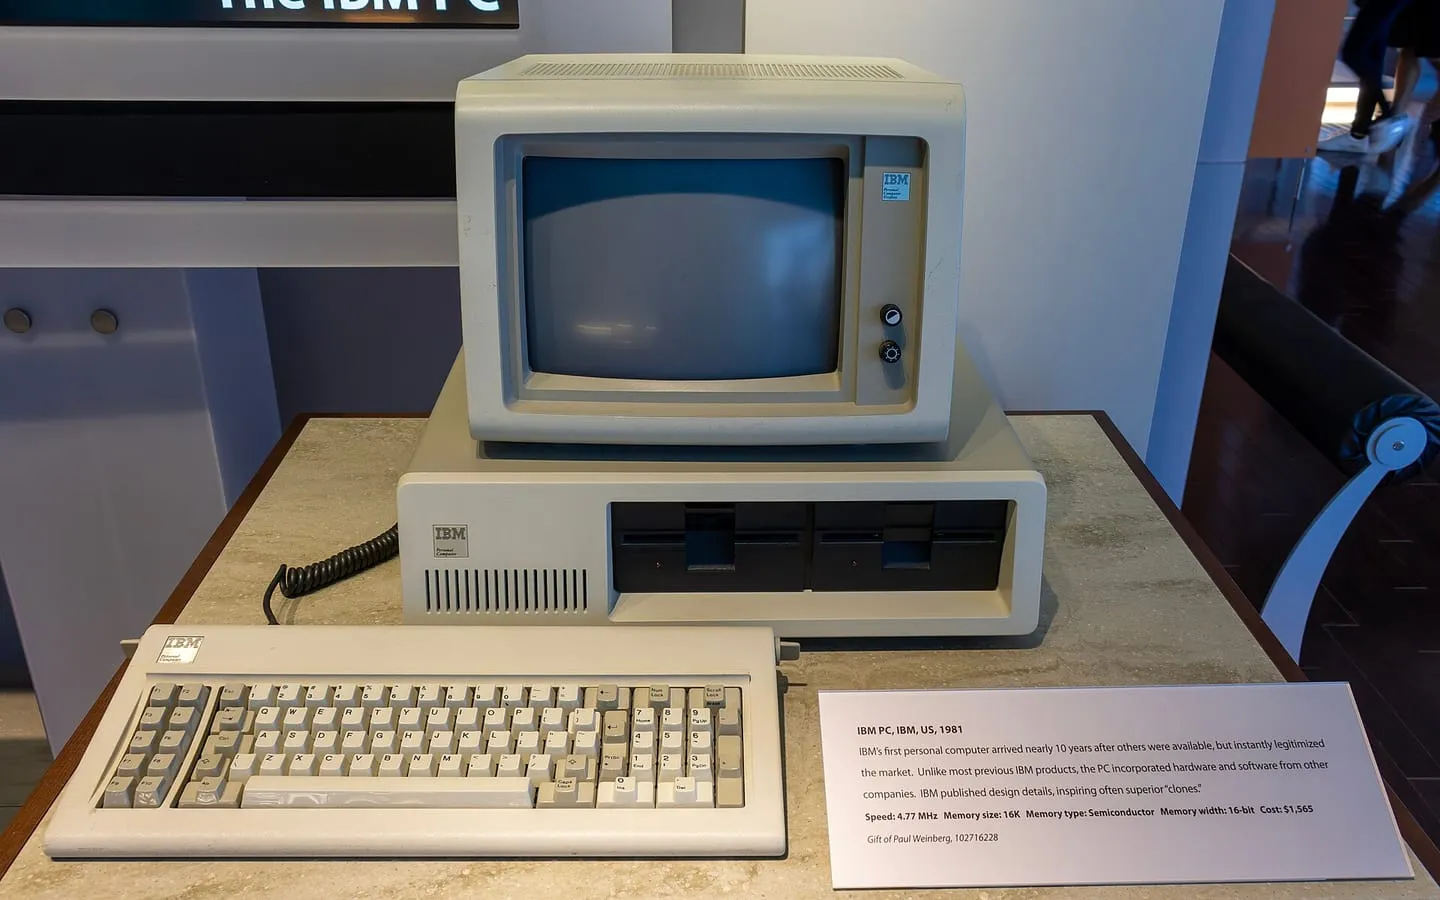
1981 · Datenverarbeitung
Der Personal Computer
Mit dem IBM PC wird der Computer zum Arbeitsgerät auf dem Schreibtisch. Rechenleistung wandert aus dem Rechenzentrum zu den Menschen – ein Gegenpol zum Großrechner.
Darauf baute die KI auf:
- Manche Agenten bedienen Programme am Bildschirm wie ein Mensch an seinem PC.
1986 · Künstliche Intelligenz
Backpropagation
Rumelhart, Hinton und Williams zeigen, wie sich Netze mit mehreren Schichten trainieren lassen. Das Verfahren trägt bis heute – doch für große Netze fehlen damals Daten und Rechenleistung.
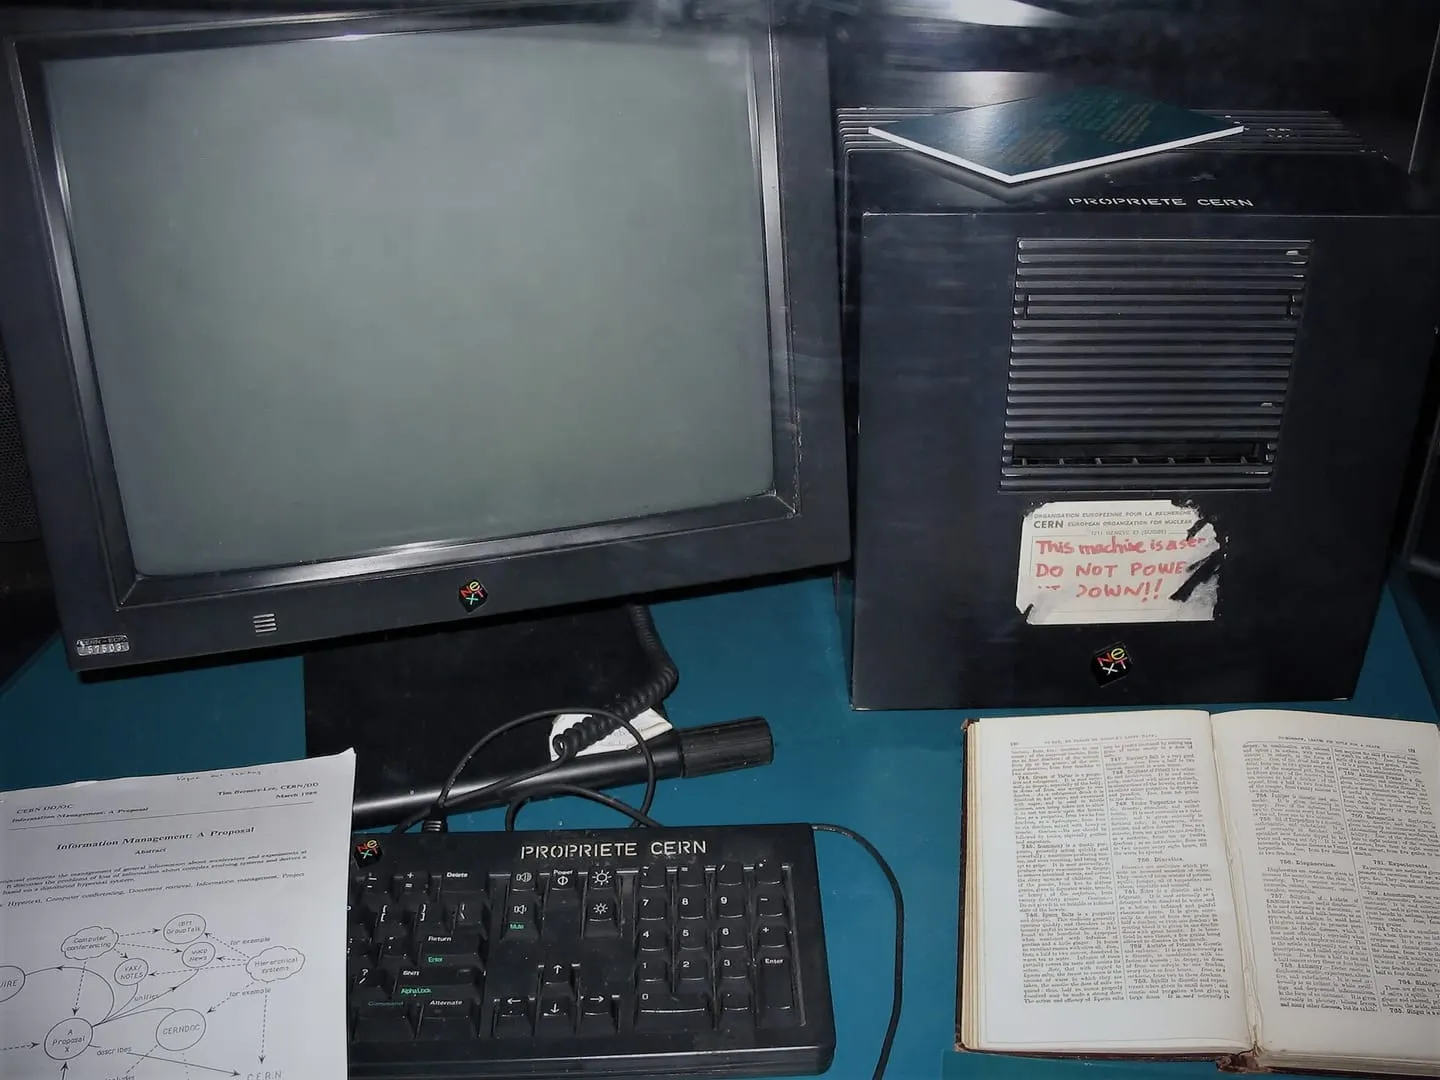
1991 · Datenverarbeitung
Das World Wide Web
Tim Berners-Lee macht am CERN das World Wide Web öffentlich: verlinkte Seiten, die jeder mit einem Browser lesen kann. In den folgenden Jahrzehnten entsteht so die größte Textsammlung der Menschheit – das spätere Lernmaterial der Sprachmodelle.
Darauf baute die KI auf:
- Die Fotos stammen aus dem Web.
- Der größte Teil der Trainingstexte stammt aus einem Archiv öffentlicher Webseiten.
- Agenten suchen und lesen im Web und bedienen Webseiten.
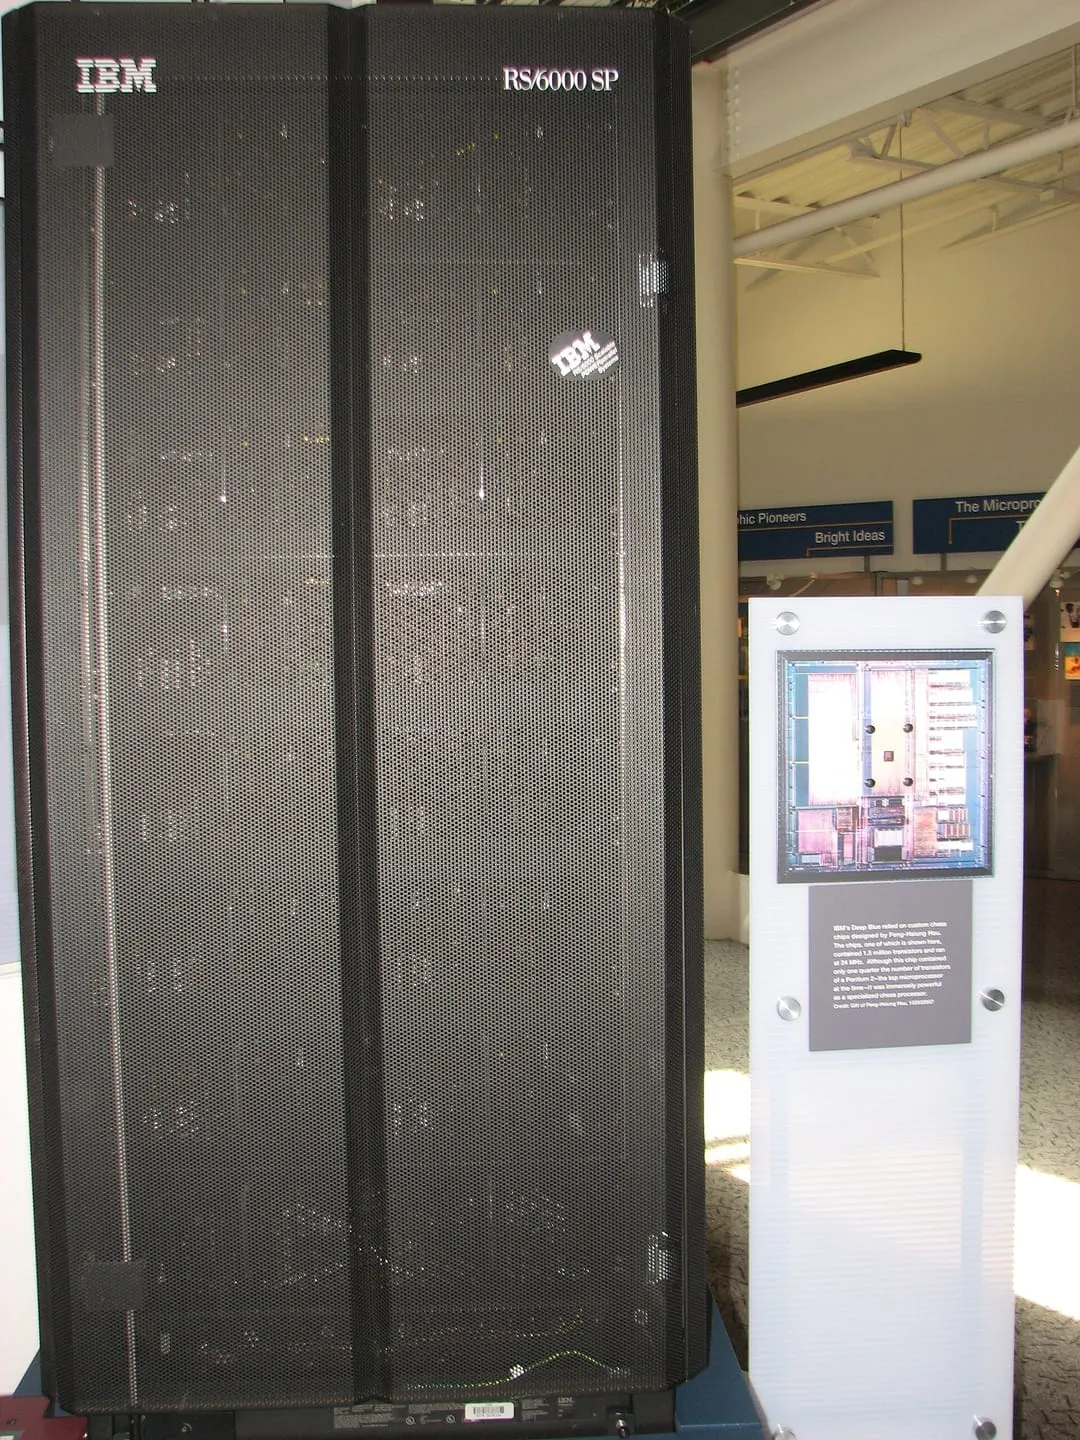
1997 · Künstliche Intelligenz
Deep Blue schlägt Kasparow
IBMs Schachcomputer gewinnt gegen Weltmeister Garri Kasparow. Er prüft im Schnitt rund 126 Millionen Stellungen pro Sekunde und bewertet sie nach Regeln, die Menschen formuliert haben – ein Triumph der Rechenkraft, nicht des Lernens.
Möglich wurde das durch:
- Deep Blue rechnete mit 480 eigens entwickelten Schach-Chips – Nachfahren des Mikroprozessors.
1998 · Datenverarbeitung
Suchmaschinen
Google wird gegründet. Suchmaschinen legen einen Index an – wie das Stichwortverzeichnis eines Buches, nur für Milliarden Seiten – und finden darin in Sekundenbruchteilen passende Treffer.
Darauf baute die KI auf:
- Gesammelt wurden die Kandidaten über Bildersuchmaschinen.
2006 · Datenverarbeitung
Die Cloud
Amazon vermietet Rechenleistung und Speicher über das Internet. Wer viel rechnen muss, braucht keinen eigenen Rechner mehr, sondern bucht ihn stundenweise in fremden Rechenzentren. Die Rechenleistung wandert zurück ins Rechenzentrum.
Darauf baute die KI auf:
- Trainiert wurde es auf einem Rechnerverbund in Microsofts Rechenzentren.
- Das Modell läuft in Rechenzentren; man erreicht es über Browser oder App.
- Jede Antwort kostet deutlich mehr Rechenzeit im Rechenzentrum als bei einem gewöhnlichen Chat.
2007 · Datenverarbeitung
Das Smartphone
Mit dem iPhone beginnt die Ära des Smartphones. Das Internet ist nun immer dabei – und mit ihm wächst die Menge an Texten, Fotos und Daten, die jeden Tag entsteht.
Darauf baute die KI auf:
- Seit 2023 gibt es ChatGPT auch als App fürs Smartphone.
2007 · Datenverarbeitung
Grafikchips rechnen für alle
Nvidia veröffentlicht CUDA: Grafikprozessoren, gebaut für Computerspiele, lassen sich nun für beliebige Rechenaufgaben programmieren. Sie führen Tausende einfache Rechnungen gleichzeitig aus – genau das, was neuronale Netze brauchen.
Darauf baute die KI auf:
- Trainiert wurde AlexNet auf zwei handelsüblichen Grafikkarten für Computerspiele.
- AlphaGo lief verteilt auf vielen Rechnern; die veröffentlichte Fassung nutzte 176 Grafikprozessoren.
- Die Architektur ist wie geschaffen für Grafikprozessoren, die viel gleichzeitig rechnen; das erste Modell wurde auf acht davon trainiert.
2009 · Künstliche Intelligenz
ImageNet
Forschende um Fei-Fei Li stellen eine Bilddatenbank vor, die auf über 14 Millionen beschriftete Fotos anwächst. Beschriftet werden sie von Tausenden Menschen, die über eine Online-Plattform gegen Bezahlung kleine Aufgaben erledigen.
Möglich wurde das durch:
- Die Fotos stammen aus dem Web.
- Gesammelt wurden die Kandidaten über Bildersuchmaschinen.
2012 · Künstliche Intelligenz
AlexNet: Der Durchbruch des Deep Learning
Ein tiefes neuronales Netz gewinnt den ImageNet-Wettbewerb mit großem Abstand. Es lernt aus über einer Million Bildern – ohne eine einzige von Menschen geschriebene Regel, woran man eine Katze erkennt. Der Beginn des Deep-Learning-Booms.
Möglich wurde das durch:
- Trainiert wurde AlexNet auf zwei handelsüblichen Grafikkarten für Computerspiele.
2016 · Künstliche Intelligenz
AlphaGo
AlphaGo schlägt den Go-Profi Lee Sedol mit 4 : 1. Das Programm hat aus Partien von Menschen gelernt und danach aus unzähligen Partien gegen sich selbst.
Möglich wurde das durch:
- AlphaGo lief verteilt auf vielen Rechnern; die veröffentlichte Fassung nutzte 176 Grafikprozessoren.
2017 · Künstliche Intelligenz
Der Transformer
Forschende bei Google stellen eine Netzarchitektur vor, die alle Wörter eines Textes gleichzeitig verarbeitet statt eines nach dem anderen. Sie wird zur Grundlage aller großen Sprachmodelle (Kapitel 3).
Möglich wurde das durch:
- Die Architektur ist wie geschaffen für Grafikprozessoren, die viel gleichzeitig rechnen; das erste Modell wurde auf acht davon trainiert.
2020 · Künstliche Intelligenz
GPT-3
OpenAI stellt ein Sprachmodell mit 175 Milliarden Parametern vor. Es löst viele Aufgaben schon nach wenigen Beispielen im Text, ohne eigens dafür trainiert zu sein.
Möglich wurde das durch:
- Der größte Teil der Trainingstexte stammt aus einem Archiv öffentlicher Webseiten.
- Trainiert wurde es auf einem Rechnerverbund in Microsofts Rechenzentren.
2022 · Künstliche Intelligenz
ChatGPT
OpenAI macht ein Sprachmodell als Chat für alle zugänglich. Nach rund zwei Monaten nutzen es schätzungsweise 100 Millionen Menschen im Monat.
Möglich wurde das durch:
- Das Modell läuft in Rechenzentren; man erreicht es über Browser oder App.
- Das Prinzip ist das des Time-Sharings: Sehr viele Menschen teilen sich zentrale Rechner und bekommen trotzdem sofort Antwort.
- Seit 2023 gibt es ChatGPT auch als App fürs Smartphone.
2024 · Künstliche Intelligenz
Reasoning-Modelle
Modelle wie OpenAIs o1 arbeiten vor der Antwort viele Zwischenschritte ab. Mehr Rechenaufwand beim Antworten bringt bessere Ergebnisse, vor allem bei Mathematik und Programmieraufgaben.
Möglich wurde das durch:
- Jede Antwort kostet deutlich mehr Rechenzeit im Rechenzentrum als bei einem gewöhnlichen Chat.
2025 · Künstliche Intelligenz
Agenten
Sprachmodelle bekommen Werkzeuge: Sie suchen im Netz, bedienen Programme und erledigen mehrschrittige Aufgaben weitgehend selbstständig. Kapitel 13 beschreibt, was sie können und wo Vorsicht geboten ist.
Möglich wurde das durch:
- Agenten suchen und lesen im Web und bedienen Webseiten.
- Manche Agenten bedienen Programme am Bildschirm wie ein Mensch an seinem PC.
Ausprobieren: Vergleichen Sie das Perzeptron (1958) mit AlexNet (2012): Beide sind lernende neuronale Netze. Was lag zwischen ihnen in der oberen Spur? Wählen Sie danach ein Ereignis der Datenverarbeitung wie das Web oder die Cloud und sehen Sie, worauf die KI später aufbaute.
Rechnen mit Lochkarten
Die Geschichte der Datenverarbeitung beginnt mit einem Verwaltungsproblem. Die Auswertung der US-Volkszählung von 1880 hatte von Hand Jahre gedauert, und die Bevölkerung wuchs weiter. Für die Zählung von 1890 setzte das Census Bureau deshalb die Maschinen des Ingenieurs Herman Hollerith ein: Die Angaben jeder Person wurden als Löcher in eine Karte gestanzt; eine Lesestation tastete die Karte mit Metallstiften ab, und wo ein Stift durch ein Loch hindurch Kontakt bekam, zählte ein elektrisches Zählwerk eins weiter. So wurden die Daten von fast 63 Millionen Menschen ausgewertet, und die Ergebnisse lagen 18 Monate früher vor als bei der Zählung zuvor (U.S. Census Bureau 2016). Aus Holleriths Firma ging später IBM hervor.

Die LochkarteKarte aus dünnem Karton, auf der Daten oder Programmzeilen als Muster gestanzter Löcher gespeichert sind. Die verbreitete IBM-Karte hat 80 Spalten; jede Spalte steht für ein Zeichen.Im Glossar ansehen blieb über ein halbes Jahrhundert das wichtigste Speichermedium. Die 1928 eingeführte IBM-Karte hatte 80 Spalten; ab 1930 gab es zwei zusätzliche Zeilen, mit denen sich auch Buchstaben darstellen ließen (IBM). Jede Spalte nahm genau ein Zeichen auf. Der Bedarf war gewaltig: 1937 stellte allein ein IBM-Werk täglich 5 bis 10 Millionen Karten her, und noch Mitte der 1950er-Jahre machten Lochkarten rund ein Fünftel des IBM-Umsatzes aus (IBM).
Auch Programme wurden später auf Karten gestanzt, eine Programmzeile pro Karte. Ein größeres Programm war ein Kartenstapel, den man sorgfältig in der richtigen Reihenfolge halten musste. Die Breite von 80 Zeichen hat übrigens überlebt: Viele Programmierwerkzeuge orientieren sich bis heute an dieser Zeilenlänge.

Eine Lochkarte stanzen
Tippen Sie einen Text ein und sehen Sie, wie ihn ein Kartenlocher der 1960er-Jahre gestanzt hätte. Verwendet wird der echte Code des verbreiteten Kartenlochers IBM 029. Die Schreibmarke im Eingabefeld zeigt auf die Spalte, die gerade erklärt wird; Sie können auch direkt auf eine Spalte der Karte tippen.
Ausprobieren: Stanzen Sie Ihren Namen. Wie viele Löcher braucht eine Ziffer, wie viele ein Buchstabe? Probieren Sie auch ein Wort mit Umlaut oder ein Satzzeichen.
Ein Gedankenexperiment macht die Größenordnungen heutiger KI greifbar. Das Sprachmodell Llama 3 des Facebook-Konzerns Meta wurde mit mehr als 15 Billionen Textbausteinen trainiert (Meta 2024). Ein solcher Baustein, ein sogenanntes Token, entspricht in englischen Texten im Schnitt etwa vier Zeichen (OpenAI Hilfe). Auf Lochkarten übertragen wären das rund 750 Milliarden Karten. Selbst bei der Produktionsrate des IBM-Werks von 1937 hätte allein das Stanzen der Rohlinge mehr als 200 Jahre gedauert.
Ein Sprachmodell auf Lochkarten – ein Überschlag
Textbausteine dienten 2024 als Trainingsmaterial für Llama 3.
Lochkarten wären nötig, um diese Textmenge zu stanzen.
Großrechner und Stapelverarbeitung
Lochkartenmaschinen konnten zählen und sortieren, aber nicht frei programmiert werden. Das änderte sich in den 1940er-Jahren. Am 12. Mai 1941 führte Konrad Zuse in Berlin die Z3 vor. Sie gilt als erster funktionsfähiger, frei programmierbarer Rechner, der im Binärsystem arbeitete – also nur mit den Zuständen „an“ und „aus“ (DPMA). Gebaut war sie aus elektromagnetischen Relais, Schaltern, die hörbar klickten. Das Original wurde im Krieg zerstört; ein Nachbau steht heute im Deutschen Museum in München.

In den USA ging 1946 der ENIAC in Betrieb. Statt Relais nutzte er Tausende Elektronenröhren und rechnete damit um ein Vielfaches schneller, füllte aber einen ganzen Saal und musste für jede neue Aufgabe von Hand umgesteckt werden. Röhren wurden heiß und fielen häufig aus. Die Lösung kam 1947 aus den Bell Laboratories: der TransistorWinziger elektronischer Schalter ohne bewegliche Teile. Moderne Chips enthalten Milliarden davon; aus ihrem Ein und Aus setzt sich jede Rechnung zusammen.Im Glossar ansehen, ein elektronischer Schalter ohne Glühfaden, kleiner, sparsamer und zuverlässiger. Er ist bis heute der Grundbaustein jedes Chips.

In den 1950er- und 60er-Jahren zog der Computer in Unternehmen und Behörden ein, als Großrechner (Mainframe)Zentraler, leistungsstarker Computer, den sich viele Nutzer und Aufgaben teilen – über Jahrzehnte das Herz der Datenverarbeitung in Unternehmen und Behörden.Im Glossar ansehen in eigens klimatisierten Räumen. Das IBM System/360 von 1964 wurde zum Inbegriff dieser Ära: eine ganze Familie von Rechnern, kleine wie große, auf denen dieselben Programme liefen. Daten lagerten auf Magnetbändern, die man nur der Reihe nach lesen konnte, und ab 1956 auf den ersten Festplatten. Die erste, IBMs RAMAC, fasste 5 Millionen Zeichen (IEEE Milestone RAMAC) – erstmals ließ sich jeder Datensatz direkt anspringen.

Gearbeitet wurde in Stapelverarbeitung (Batch)Arbeitsweise, bei der Aufträge gesammelt und ohne Eingreifen des Menschen nacheinander abgearbeitet werden. Das Ergebnis kommt später – früher oft erst am nächsten Tag.Im Glossar ansehen. Man gab seinen Kartenstapel am Schalter des Rechenzentrums ab, der Rechner arbeitete die gesammelten Aufträge nacheinander ab, und das Ergebnis lag als Ausdruck oft erst am nächsten Tag im Fach. Ein einziger Tippfehler kostete einen ganzen Tag.
Dieses Muster hat sich in der KI erhalten. Das Training eines Sprachmodells ist eine gewaltige Stapelverarbeitung: Ein Rechenzentrum arbeitet wochenlang an einem einzigen Auftrag, ohne dass jemand eingreift, und erst am Ende steht fest, ob das Ergebnis taugt.
Vom Terminal zum Personal Computer
Wer an einem Großrechner arbeitete, wollte nicht bis morgen auf eine Antwort warten. Am Massachusetts Institute of Technology (MIT) wurde deshalb im November 1961 das System CTSS vorgeführt (IEEE Computer Society 2011). Es teilte die Rechenzeit in kleine Scheiben und verteilte sie reihum an viele Nutzer, die gleichzeitig an TerminalEin- und Ausgabegerät aus Bildschirm (früher Fernschreiber) und Tastatur, das selbst kaum rechnet und mit einem entfernten Rechner verbunden ist.Im Glossar ansehen saßen – zunächst Fernschreibern, später Bildschirmgeräten. Jeder hatte den Eindruck, den Rechner für sich allein zu haben, und bekam sofort Antwort. Dieses Time-Sharing (Dialogbetrieb)Ein Rechner teilt seine Rechenzeit reihum in kleinen Scheiben an viele gleichzeitig arbeitende Nutzer aus. Jeder hat den Eindruck, den Rechner für sich allein zu haben, und bekommt sofort Antwort.Im Glossar ansehen, im Deutschen auch Dialogbetrieb genannt, machte aus dem Rechner einen Gesprächspartner.

Wer heute einem Chatbot eine Frage stellt, nutzt im Grunde dasselbe Prinzip. Das Sprachmodell läuft nicht auf dem eigenen Laptop oder Handy, sondern in einem Rechenzentrum, das sich Millionen Menschen teilen. Das Gerät in der Hand ist, technisch gesehen, ein Terminal.
Parallel wurde die Technik immer kleiner. 1971 brachte Intel mit dem 4004 den ersten MikroprozessorEin vollständiger Rechenkern auf einem einzigen Chip. Seit dem Intel 4004 von 1971 das Herz fast jedes Computers.Im Glossar ansehen auf den Markt: einen vollständigen Rechenkern auf einem einzigen Chip, mit 2.300 Transistoren (Intel). Ein heutiger KI-Chip enthält rund 90 Millionen Mal so viele. Rechnet man nach, hat sich die Zahl der Transistoren pro Chip seither im Schnitt etwa alle zwei Jahre verdoppelt – eine Entwicklung, die nach dem Intel-Mitgründer Gordon Moore als Mooresches Gesetz bekannt ist.
Vom ersten Mikroprozessor zum KI-Chip
Transistoren hat ein Nvidia-Grafikprozessor der Blackwell-Generation von 2024, gebaut für KI.
so viele Transistoren sind es heute auf einem einzelnen Chip.
Mit dem Mikroprozessor wurde der Computer erschwinglich. Ab 1981 stand der IBM Personal Computer auf Schreibtischen in Büros, bald auch zu Hause. Erstmals gehörte die Rechenleistung den Menschen, die damit arbeiteten, statt in einem fernen Rechenzentrum zu stehen.

Im Rückblick zeigt sich eine Pendelbewegung, die bis heute anhält. Rechenleistung wanderte vom zentralen Großrechner auf den einzelnen Schreibtisch – und mit Cloud und KI wieder zurück in große Rechenzentren.
Netz, Suche und Cloud
1969 wurden Rechner an Universitäten in Kalifornien und Utah zum ARPANET verbunden, einem Forschungsnetz des US-Verteidigungsministeriums und Vorläufer des Internets. Seine Grundidee trägt bis heute: Nachrichten werden in kleine Datenpakete zerlegt, die einzeln ihren Weg durch das Netz suchen und am Ziel wieder zusammengesetzt werden.
Für die breite Öffentlichkeit wurde das Netz erst durch das World Wide Web nutzbar. Tim Berners-Lee entwickelte es am Forschungszentrum CERN bei Genf; im August 1991 machte er es öffentlich, 1993 gab das CERN die Technik zur freien Nutzung frei (CERN). Verlinkte Seiten, die jeder mit einem Browser lesen und jeder selbst veröffentlichen konnte, ließen in den folgenden Jahrzehnten die größte Textsammlung entstehen, die es je gab. Aus ihr lernen heute die Sprachmodelle: Beim Sprachmodell GPT-3 etwa stammte der größte Teil des Trainingsmaterials aus einem frei verfügbaren Archiv von Webseiten (Brown et al. 2020).

Je größer das Netz wurde, desto wichtiger wurde das Finden. Suchmaschinen wie das 1998 gegründete Google lesen nicht bei jeder Anfrage das ganze Netz, sondern legen vorab einen SuchindexVerzeichnis, das zu jedem Wort festhält, in welchen Dokumenten es vorkommt – wie das Stichwortverzeichnis eines Buches. Damit findet eine Suchmaschine Treffer, ohne alle Seiten neu lesen zu müssen.Im Glossar ansehen an – ein Verzeichnis, das zu jedem Wort festhält, auf welchen Seiten es vorkommt, wie das Stichwortverzeichnis am Ende eines Buches. Ein Sprachmodell funktioniert grundlegend anders: Es schlägt normalerweise nicht nach, sondern trägt sein Wissen in verdichteter Form in sich. Kapitel 5 vertieft diesen Unterschied.
Um 2006 und 2007 kamen drei Entwicklungen zusammen, ohne die heutige KI kaum denkbar wäre. Amazon begann 2006, Rechenleistung und Speicher über das Internet stundenweise zu vermieten – die CloudRechenleistung und Speicher, die ein Anbieter in seinen Rechenzentren bereithält und über das Internet nach Bedarf vermietet.Im Glossar ansehen. 2007 kam das iPhone auf den Markt und mit ihm das Internet für die Hosentasche, das die Menge an Texten, Fotos und Daten weiter vervielfachte. Im selben Jahr machte Nvidia seine Grafikprozessoren mit der Programmierumgebung CUDA für beliebige Rechenaufgaben nutzbar. Diese GPU (Grafikprozessor)Ursprünglich für Computergrafik entwickelter Chip, der sehr viele einfache Rechnungen gleichzeitig ausführt. Genau das braucht das Training neuronaler Netze.Im Glossar ansehen waren für Computerspiele gebaut, in denen Millionen Bildpunkte gleichzeitig berechnet werden müssen. Genau diese Fähigkeit, sehr viele einfache Rechnungen parallel auszuführen, brauchen neuronale Netze.

Die Geschichte der KI: Wellen aus Hoffnung und Ernüchterung
Während die Datenverarbeitung Schritt für Schritt leistungsfähiger wurde, verlief die Geschichte der künstlichen Intelligenz in Wellen. Phasen großer Erwartungen wechselten sich mit Phasen der Ernüchterung ab.
Die Anfänge
1950 schlug Alan Turing ein Imitationsspiel vor: Wenn ein Mensch im schriftlichen Gespräch nicht zuverlässig erkennen kann, ob er mit einem Menschen oder einer Maschine spricht, sollte man der Maschine dann nicht Denkvermögen zugestehen? (Turing 1950) Kapitel 10 geht auf diesen Turing-Test und seine Grenzen ein.
Ihren Namen bekam die Disziplin 1956 bei einem Sommer-Workshop am Dartmouth College in New Hampshire. Im Antrag dafür prägten John McCarthy und seine Mitstreiter den Begriff „Artificial Intelligence“ und zeigten sich zuversichtlich, dass eine sorgfältig ausgewählte Gruppe von Wissenschaftlern in einem einzigen Sommer bedeutende Fortschritte erzielen könne (McCarthy et al. 1955).
Zwei Jahre später stellte der Psychologe Frank Rosenblatt das Perzeptron vor, ein künstliches Neuron, das aus Beispielen lernte. Bei der ersten Vorführung im Juli 1958 lief es als Simulation auf einem IBM-Großrechner und lernte nach 50 Versuchen, Lochkarten mit einer Markierung auf der linken Seite von solchen mit einer Markierung rechts zu unterscheiden (Cornell Chronicle 2019). Es war im Kern das, was Sie in Kapitel 1 als einzelnes Neuron ausprobiert haben.
1966 veröffentlichte Joseph Weizenbaum am MIT das Programm ELIZA, den ersten ChatbotProgramm, mit dem man sich in natürlicher Sprache schriftlich unterhalten kann. Frühe Chatbots folgten festen Mustern; heutige beruhen auf großen Sprachmodellen.Im Glossar ansehen (Weizenbaum 1966). ELIZA lief im Time-Sharing-Betrieb: Man tippte am Terminal einen Satz und bekam sofort eine Antwort. In seiner bekanntesten Rolle ahmte das Programm eine Gesprächstherapeutin nach und gab Aussagen nach einfachen Mustern als Frage zurück – aus „Ich bin unglücklich“ wurde etwa „Warum sind Sie unglücklich?“. ELIZA verstand nichts. Trotzdem schrieben viele Menschen dem Programm echtes Verständnis zu; Weizenbaum berichtet, seine Sekretärin habe ihn nach wenigen Sätzen gebeten, den Raum zu verlassen (Weizenbaum 1976). Dass Menschen hinter flüssiger Sprache vorschnell Verstehen vermuten, nennt man seither ELIZA-Effekt. Weizenbaum, 1923 in Berlin geboren und als Jugendlicher vor den Nationalsozialisten in die USA geflohen, wurde darüber zu einem der ersten und bekanntesten Kritiker der KI.

Winter und Expertensysteme
Die frühen Erfolge weckten Erwartungen, die sich nicht erfüllten. 1969 zeigten Marvin Minsky und Seymour Papert in ihrem Buch über Perzeptronen, dass ein einzelnes solches Neuron grundsätzlich nur gerade Trennlinien ziehen kann (Minsky & Papert 1969) – genau die Grenze, an der in Kapitel 1 das Netz mit nur einem Neuron am Ring scheiterte. In Großbritannien kam 1973 ein Gutachten des Mathematikers James Lighthill zu dem Schluss, die KI-Forschung habe ihre großen Versprechen nicht eingelöst (Lighthill 1973). Fördergelder wurden gestrichen, in Großbritannien wie in den USA. Für diese Phasen schwindenden Interesses hat sich der Begriff KI-WinterPhasen, in denen nach übertriebenen Erwartungen Fördergelder und Interesse an KI-Forschung stark zurückgingen – vor allem in den 1970er- und späten 1980er-Jahren.Im Glossar ansehen eingebürgert.
Um 1980 kam die KI in anderer Gestalt zurück: als ExpertensystemProgramm der symbolischen KI, das das Wissen von Fachleuten als Sammlung von Wenn-dann-Regeln enthält und daraus Schlüsse zieht.Im Glossar ansehen. Statt aus Beispielen zu lernen, enthielten diese Programme das Wissen von Fachleuten als Tausende Wenn-dann-Regeln. Ein bekanntes Beispiel ist XCON, das ab 1980 beim Computerhersteller Digital Equipment Corporation die Bestellungen von Rechnersystemen prüfte und zusammenstellte (McDermott 1982). Solche Systeme leisteten in eng begrenzten Aufgaben gute Dienste. Doch die Regeln mussten von Hand erfasst und ständig gepflegt werden, und an allem, was sie nicht vorsahen, scheiterten die Programme. Ende der 1980er-Jahre folgte der zweite KI-Winter.
Fast unbemerkt fiel in diese Zeit ein Fortschritt, der später entscheidend werden sollte: 1986 beschrieben David Rumelhart, Geoffrey Hinton und Ronald Williams, wie sich Netze mit mehreren Schichten trainieren lassen (Rumelhart, Hinton & Williams 1986). Das Verfahren funktionierte, doch für große Netze fehlten noch Daten und Rechenleistung.
Lernen aus Daten
Im Mai 1997 schlug IBMs Schachcomputer Deep Blue den amtierenden Weltmeister Garri Kasparow. Sein Erfolg beruhte auf Rechenkraft und auf von Menschen formulierten Bewertungsregeln: 480 eigens entwickelte Schach-Chips prüften im Schnitt rund 126 Millionen Stellungen pro Sekunde (Campbell, Hoane & Hsu 2002). Gelernt hatte Deep Blue dabei nichts.

Gleichzeitig setzte sich in vielen Anwendungen ein anderer Ansatz durch. Spamfilter, maschinelle Übersetzung und Kaufempfehlungen im Onlinehandel beruhten zunehmend auf statistischem Machine Learning (maschinelles Lernen)Statt Regeln vorzugeben, zeigt man dem System viele Beispiele; es leitet die Muster selbst ab.Im Glossar ansehen aus großen Datenmengen statt auf handgeschriebenen Regeln. Je mehr Daten das Internet lieferte, desto besser funktionierte das.
Für die Bilderkennung fehlte es lange an genügend beschrifteten Beispielen. Diese Lücke schloss die Informatikerin Fei-Fei Li mit ihrem Team: Ab 2009 bauten sie die Bilddatenbank ImageNet auf (Deng et al. 2009). Die Fotos stammten aus dem Netz und wurden über Bildersuchmaschinen gesammelt; beschriftet wurden sie von Tausenden Menschen, die über eine Online-Plattform gegen Bezahlung kleine Aufgaben erledigten. ImageNet wuchs auf über 14 Millionen beschriftete Bilder (Russakovsky et al. 2015).
2012 kam der Durchbruch. Ein tiefes neuronales Netz namens AlexNet gewann den ImageNet-Wettbewerb mit großem Abstand. Trainiert wurde es auf zwei handelsüblichen Grafikkarten für Computerspiele (Krizhevsky, Sutskever & Hinton 2012). Hier liefen die beiden Geschichten sichtbar zusammen: ein Verfahren aus der KI-Forschung, Daten aus dem Web und Rechenleistung aus der Spieleindustrie. Vier Jahre später besiegte das Programm AlphaGo den Go-Profi Lee Sedol mit 4 : 1 (Google DeepMind 2016). Es hatte aus Partien von Menschen gelernt, dann aus unzähligen Partien gegen sich selbst, und lief verteilt auf vielen Rechnern; die in der Fachzeitschrift Nature beschriebene Fassung nutzte dafür 176 Grafikprozessoren (Silver et al. 2016).
Die Ära der Sprachmodelle
2017 stellten Forschende bei Google eine neue Netzarchitektur vor, den Transformer (Vaswani et al. 2017). Er verarbeitet alle Wörter eines Textes gleichzeitig statt eines nach dem anderen und passt damit ideal zu Grafikprozessoren, die viel parallel rechnen. Kapitel 3 erklärt, wie er funktioniert. Auf dieser Architektur bauen alle großen Sprachmodelle auf. GPT-3 zeigte 2020 mit 175 Milliarden Parametern, dass ein ausreichend großes Modell viele Aufgaben schon nach wenigen Beispielen lösen kann, ohne eigens dafür trainiert zu sein (Brown et al. 2020).
Am 30. November 2022 machte OpenAI ein solches Modell als ChatGPT für alle zugänglich (OpenAI 2022). Nach Schätzungen von Analysten nutzten es bereits zwei Monate später rund 100 Millionen Menschen im Monat – schneller war bis dahin keine Anwendung gewachsen (Reuters 2023). Seither entwickelt sich das Feld in hohem Tempo. Seit 2024 gibt es sogenannte Reasoning-Modelle, die vor ihrer Antwort viele Zwischenschritte durcharbeiten und dafür mehr Rechenzeit aufwenden (OpenAI 2024). Seit 2025 übernehmen Agenten zunehmend mehrschrittige Aufgaben: Sie suchen im Netz, bedienen Programme und arbeiten Aufträge weitgehend selbstständig ab. Kapitel 13 beschreibt, was sie können und wo Vorsicht geboten ist.
Was die beiden Geschichten verbindet
Viele Begriffe der heutigen KI erscheinen weniger fremd, wenn man sie neben ihre Vorläufer aus der Datenverarbeitung stellt. Die Analogien sind nicht perfekt, aber sie helfen bei der Einordnung.
Ein Unterschied ist dabei grundlegend. Ein klassisches Programm tut, was in ihm steht; wer seinen Text liest, kann nachvollziehen, warum es sich so verhält. Ein trainiertes Modell dagegen wurde nicht geschrieben, sondern eingestellt – Milliarden von Gewichten, die niemand einzeln festgelegt hat. Das macht es vielseitiger als jedes Programm, aber auch schwerer zu durchschauen.
Quellen zu diesem Kapitel
- Turing, A. M. (1950): Computing Machinery and Intelligence. Mind 59 (236), 433–460.
- U.S. Census Bureau (2016): History and the Census – Herman Hollerith and Mechanical Tabulation. Census History Stories, Januar 2016.Link
- IBM: The IBM punched card. IBM Heritage (abgerufen November 2026).Link
- Meta (2024): Introducing Meta Llama 3 – The most capable openly available LLM to date. Blogbeitrag, 18. April 2024.Link
- OpenAI Help Center: What are tokens and how to count them? (Faustregel für englische Texte: ein Token entspricht etwa vier Zeichen; abgerufen November 2026).Link
- Deutsches Patent- und Markenamt: Konrad Zuse. Reihe „Meilensteine – Computerpioniere“ (abgerufen November 2026).Link
- IEEE / Engineering and Technology History Wiki: Milestones – RAMAC, 1956.Link
- IEEE Computer Society (2011): Compatible Time-Sharing System (1961–1973). Fiftieth Anniversary Commemorative Overview.Link
- Intel: The Story of the Intel 4004 – Intel’s First Microprocessor. Intel Museum (abgerufen November 2026).Link
- Nvidia (2024): NVIDIA Blackwell Platform Arrives to Power a New Era of Computing. Pressemitteilung, 18. März 2024.Link
- CERN: Web@30 – A short history of the Web (abgerufen November 2026).Link
- Brown, T. et al. (2020): Language Models are Few-Shot Learners. NeurIPS 2020.Link
- McCarthy, J., Minsky, M. L., Rochester, N. & Shannon, C. E. (1955): A Proposal for the Dartmouth Summer Research Project on Artificial Intelligence. Nachdruck in AI Magazine 27 (4), 2006.Link
- Lefkowitz, M. (2019): Professor’s perceptron paved the way for AI – 60 years too soon. Cornell Chronicle, 25. September 2019.Link
- Weizenbaum, J. (1966): ELIZA – A Computer Program for the Study of Natural Language Communication Between Man and Machine. Communications of the ACM 9 (1), 36–45.Link
- Weizenbaum, J. (1976): Computer Power and Human Reason – From Judgment to Calculation. San Francisco: W. H. Freeman. Deutsch: Die Macht der Computer und die Ohnmacht der Vernunft (1977).
- Minsky, M. & Papert, S. (1969): Perceptrons – An Introduction to Computational Geometry. Cambridge, MA: MIT Press.
- Lighthill, J. (1973): Artificial Intelligence – A General Survey. In: Artificial Intelligence: a paper symposium. London: Science Research Council.
- McDermott, J. (1982): R1 – A Rule-Based Configurer of Computer Systems. Artificial Intelligence 19 (1), 39–88.Link
- Rumelhart, D. E., Hinton, G. E. & Williams, R. J. (1986): Learning representations by back-propagating errors. Nature 323, 533–536.Link
- Simon, H. A. (1960): The New Science of Management Decision. New York: Harper & Row; nachgedruckt in: The Shape of Automation for Men and Management (1965). Zur Herkunft des Zitats: Quote Investigator, 11. November 2020.Link
- Campbell, M., Hoane, A. J. & Hsu, F. (2002): Deep Blue. Artificial Intelligence 134 (1–2), 57–83.Link
- Deng, J. et al. (2009): ImageNet – A Large-Scale Hierarchical Image Database. IEEE Conference on Computer Vision and Pattern Recognition (CVPR), 248–255.Link
- Russakovsky, O. et al. (2015): ImageNet Large Scale Visual Recognition Challenge. International Journal of Computer Vision 115 (3), 211–252.Link
- Krizhevsky, A., Sutskever, I. & Hinton, G. E. (2012): ImageNet Classification with Deep Convolutional Neural Networks. Advances in Neural Information Processing Systems 25 (NIPS 2012).Link
- Google DeepMind (2016): AlphaGo – Match gegen Lee Sedol, Seoul, März 2016.Link
- Silver, D. et al. (2016): Mastering the game of Go with deep neural networks and tree search. Nature 529, 484–489.Link
- Vaswani, A. et al. (2017): Attention Is All You Need. Advances in Neural Information Processing Systems 30 (NeurIPS).Link
- OpenAI (2022): Introducing ChatGPT. Blogbeitrag, 30. November 2022.Link
- Hu, K. (2023): ChatGPT sets record for fastest-growing user base – analyst note. Reuters, 2. Februar 2023 (zitiert eine UBS-Analyse).Link
- OpenAI (2024): Learning to reason with LLMs. Blogbeitrag, 12. September 2024.Link